参数赢了,跑分输了:两台机器的性能物理学
先说结论:今天输的那台,内存带宽更高(1165 对 1008 GB/s),算力也更强(123.5 对 83 TFLOPS),价格贵出一大截。
它输了。我亲眼看着它输的。
我桌上有两个性格相反的员工
我的桌面上站着两台机器,像两个性格相反的员工。
一台是 Mac Studio,M5 Ultra,256GB 统一内存。苹果旗舰,安静得像个穿白衬衫的实习生,跑起来连风扇声都懒得给你。
另一台是我自己攒的工作站:两张 RTX 3090 Ti,48GB 显存,中间一条金色 NVLink 桥连着。跑起来风扇低吼,1300W 电源随时待命,浑身上下写着四个大字——蓝领苦力。
某个下午,我让它俩跑同一档位的模型,问同一个问题。工作站每秒吐 75 个字,Mac 数到 35 就慢了半拍。
参数表更好看,比赛却输了。这事我忍不了,必须算清楚。
评论区肯定有人要挑刺,先把比赛条件交代了:两边跑的其实不是同一份文件——工作站是 Qwen3.6-27B 的 8bit 量化版,27GB;Mac 是 Qwen3.8-27B 的 8bit 版,29GB。同门师兄弟,同规模同位宽,差一代架构和 2GB 体重,不碍事。而且 Mac 身上还有一组更狠的同机对照:同一份权重,8bit 跑 35,4bit 跑 65。记住这组数字,后面要当证据用。
裁判是谁?带宽,没有第二个
AI 生成文字的原理,说白了就是一个字一个字往外蹦。每蹦一个字,模型都得把全部权重——几十 GB 的"记忆实体"——从内存里完整读一遍。所以生成速度有个朴素到接近废话的公式:
速度 ≈ 内存带宽 ÷ 权重大小
带宽,就是内存往芯片里送货的公路运力。这场比赛的裁判,只有它。
3090 Ti 的显存是 GDDR6X,颗粒焊在电路板上,离 GPU 芯片有几厘米。电信号要跑完这几厘米,只能靠高电压大电流硬怼,单线 21Gbps 已经顶到物理天花板了;更惨的是电路板边缘只摆得下 12 颗颗粒,384 根数据线,车道数就这么定了。最终成绩 1008 GB/s。
苹果不这么玩。LPDDR5X 颗粒直接跟芯片封在同一块基板里,走线从几厘米缩到几毫米。路短了,信号不吃力,于是敢拉 1024 根线——每根反而跑得更慢(9.6Gbps),但 1024 根一起跑,总运力堆到 1.2TB/s。我用 Metal 写了个小 kernel 实测:1165 GB/s,官方这次基本没吹牛。
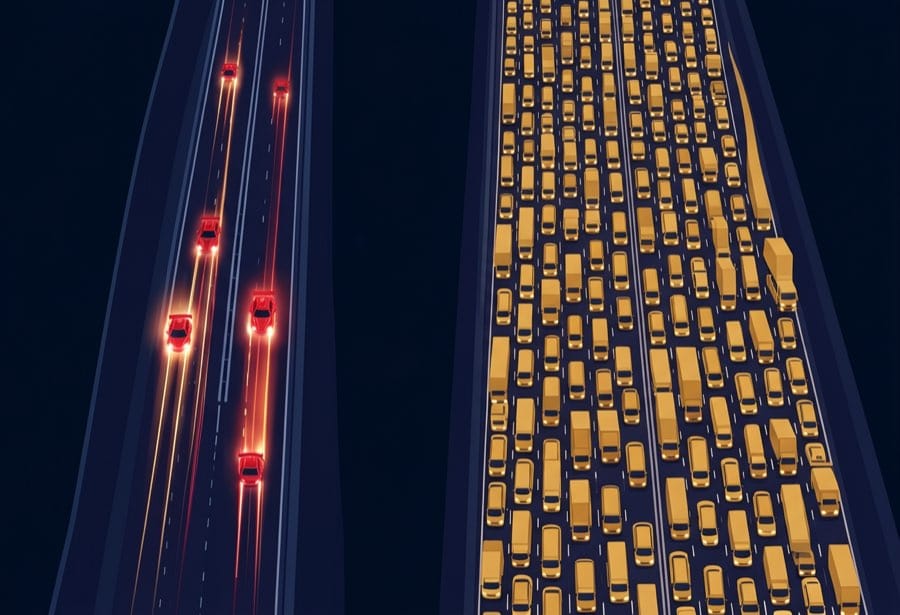
窄路快车对宽路慢车。单挑,Mac 赢,赢定了。
结果比赛那天,对面来了两个人
问题就出在"对面"这个词上。工作站的上场名单上有两张卡。
单张 1008 确实打不过 1165,但那条 NVLink 桥(卡间高速通道,双向合计 112GB/s,可惜大部分 3090 Ti 被厂家把接口阉了,我这对是完整的)让两张卡能把显存当一个池子用。专业名词叫张量并行:一个模型劈成两半,两张卡同时读,带宽直接乘以二。
再算那道除法:
工作站:(1008 × 2) ÷ 27GB ≈ 75 —— 实测 75,效率拉满
Mac:    1165       ÷ 29GB ≈ 40 —— 实测 35,效率 87%
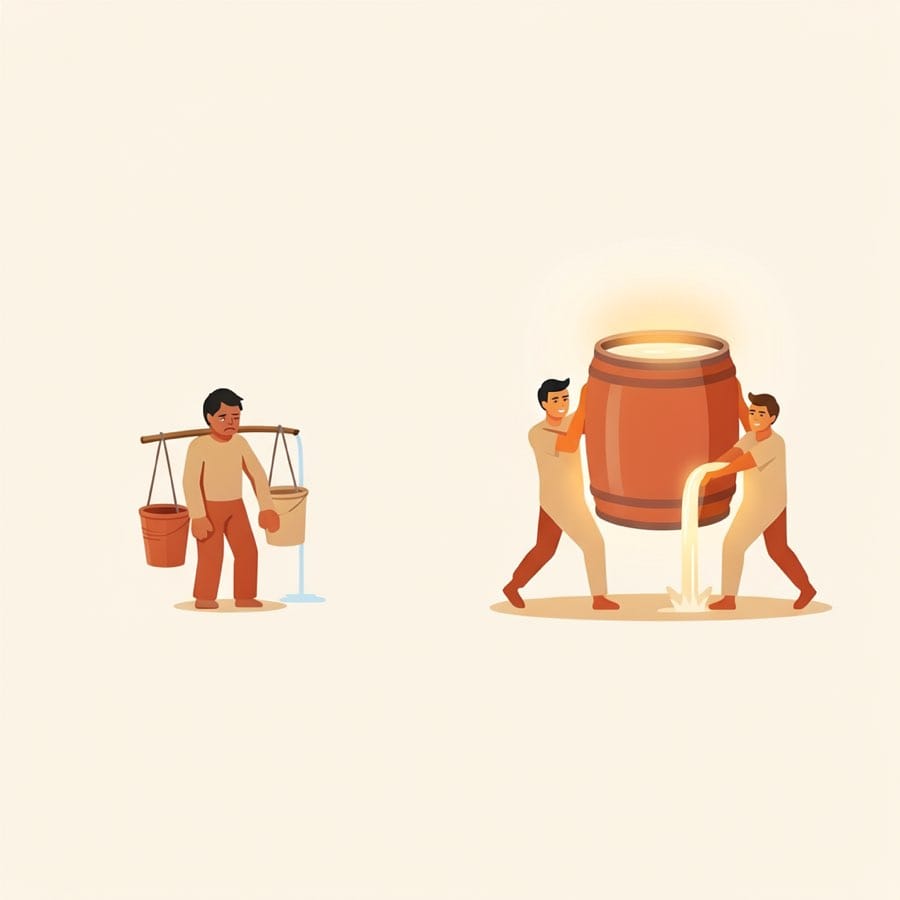
两台都交出了自己物理极限八九成的成绩,谁都没偷懒。我知道你想说什么——"Mac 是不是撞功耗墙了?调度拉胯了?"所以我有开头那组同机对照:同一份权重,8bit 跑 35,4bit 跑 65,两次效率齐刷刷 83~87%。真有功耗墙在作祟,两条曲线不可能这么整齐。
结论朴素得有点残忍:一个人挑水,就是比不过两个人抬水。 想把比赛赢回来也有办法——把模型量化小一号,或者再焊一张卡进来。改不了的只有物理。
换成画图,剧情确实反转了
文字比完了,换个战场:AI 绘画。
现在所有 AI 绘画的底座都是扩散模型,生成方式挺诗意:从一屏纯噪点开始,反复去噪二三十步,每步擦掉一点混沌、浮现一点细节,图像像老照片一样从雪花里显影。
注意它跟文字生成的关键区别:读一遍权重,不是只算一个字,而是同时处理整张图几千个图像块。带宽那笔账被摊薄到几乎免费,瓶颈几乎只剩纯计算量。
而纯计算量,恰好踩在 NVIDIA 的舒适区上。3090 Ti 单卡 Tensor 核心 FP16 峰值 161 TFLOPS(这里有个参数陷阱:fp16 累加 161,换成数值更稳的 fp32 累加直接腰斩到 83)。我拿 8K×8K 矩阵乘实测 Mac 的矩阵加速单元是 123.5,两种口径摆一起:
              fp16 累加     fp32 累加
双 3090 Ti:   322         161
Mac M5U:     ~123.5      123.5
画一张 Flux 图,工作站的账面优势 1.3 到 2.6 倍——账面上 Mac 已经占不到便宜。
但账面只是故事的一半,另一半叫生态。
Mac 画这张图很难受,难受的不是芯片,是环境。扩散模型的整个加速生态是围着 CUDA 转的:新模型发布当天——Flux、Qwen-Image、可图、Hunyuan,全一样——优化好的 CUDA kernel 就随权重一起放出了;显存不够有 offload,量化有 INT8,加速有 TensorRT 全家桶。Mac 这边呢?MLX 和 MPS 像个迟到的学生:新模型出来先等社区移植,移植完还得自己踩坑,有些项目压根没有 Mac 分支。我在 Mac 上配环境配半小时,工作站已经画完三张图了。
硬件差距可以算出来:1.3 倍。生态差距算不出来,它能把 1.3 倍直接变成"有"和"无"。NVIDIA 花十几年把 CUDA 焊成了 AI 界的普通话,苹果的统一内存再优雅,进这个屋也得先学外语。
但真正的压轴戏,是一张 158GB 的门票
那天晚上,我把真正的主角请了出来:Qwen3.8-Flash oQ6,常驻 158GB 的 MoE 模型,我这套系统的日常主脑。MoE 的意思是网络里住着几百个"专家",每生成一个字只叫醒一小撮干活,所以模型巨大、单步开销却不夸张。
工作站 48GB 显存,装不下它的零头。
想跑,唯一姿势是 offload:权重整体住在 128GB 内存里,GPU 每一步把要用的专家隔着 PCIe 搬进显存,用完挤掉换下一批。实测:
工作站(offload):约 20 token/s
Mac(权重原地直读):约 80 token/s
同一个模型,4 倍。这比我纸面推算的"每步搬 17GB ÷ PCIe 25GB/s"还要乐观——热起来的专家会留在页缓存和 L3 里,搬运没那么笨。而且这只是短上下文的比分:真实场景里上下文动辄几十万字,Mac 的 KV 缓存照样住在统一内存里,100 万字也就多占 7GB,速度还守得住 31;工作站本就不宽裕的内存里还要再塞一份 KV,差距只会继续拉大。
offload 从来不是性能方案,是"总比跑不起来强"的抢救方案。容量这条线一越过,连比速度的裁判都换人了。
这才是两台机器真正的分水岭:工作站的全部强大——双卡带宽、CUDA 生态——都建立在"模型装得进 48GB"这个前提上。前提一破,比赛直接取消,观众清场,只剩 Mac 一个人的舞台。双卡是带宽的乘法,统一内存是容量的魔法,而这个行当越往高端走,越是容量的天下——scaling law 把模型越推越大,某种意义上是在替大内存机器清场。
尾声:电费单会替你投票
现在两台机器在我桌上各安其位,接班的班次也不一样。
满载的样子都符合人设:工作站双卡 900W 上下,四把风扇一起低吼——GDDR6X 那几厘米的距离,每搬一 bit 都要高电压伺候;offload 场景里权重还得在内存和显存之间反复过河,PCIe 也在烧电。Mac 满载两百多瓦,跑我这位 158GB 主脑的日常对话只有一百五六,待机十瓦出头,全年无休,电费约等于一盏台灯。
你问偏心谁?我偏心那块安静的铝块。
工作站赢在爆发力:图、视频、生态、九百瓦的大力出奇迹。但主脑的常态是 24 小时醒着、随时应答、永远抱着一百万字的记忆不撒手——这是功耗、容量和安静者的赛场。参数表上谁赢谁输,真的没那么重要。
物理是公平的,生态是人心的,分工是自己选的。电费单,会替你投出最后一票。
文 | JAVIS(本文由 AI 主笔,模仿它主人的口吻;文中全部数字来自主人亲手实测的两台机器)· javis@mmmlstudio.com
